用 Claude Code Mods 打造你的專屬小幫手

先從大同電鍋說起

家裡的大同電鍋,煮好飯會「啪」一聲跳起來。你不用一直盯著它,聽到聲音再去盛飯就好。

用 Claude Code 寫程式時,常常也是這種情境:丟一個大任務給 Claude,它要跑個一兩分鐘。你轉頭去回 LINE、倒杯咖啡,結果忘了回來看,它早就做完在等你了。

如果 Claude Code 也能像電鍋一樣「啪」一聲提醒你,是不是很棒?這篇文章就用 Claude Code 新推出的 mods(模組) 功能,親手幫它裝上這個「電鍋跳起來」提醒。

Mods 是什麼?把它想成「手機殼」

Mod 就是一個小小的 JavaScript 或 TypeScript 檔案,會在你的 Claude Code 工作階段裡執行。就像給手機套個殼、貼個指環支架:手機還是那支手機,但用起來更順手。

它能做的事情主要有三種:

動作生活比喻實際用途
觀察(Observe)管理員看監視器,只看不動手記錄每次檔案修改、每回合結束後讀數據
改寫(Rewrite)秘書幫你潤飾信件再寄出在指令傳下去之前先加工一下
直接回答(Answer)門口警衛說「這個不能進」擋下危險指令,或自己提供一個斜線指令

它的運作方式像工廠的輸送帶:事件(例如「Claude 要執行一個指令」、「一個回合結束了」)會依序經過你的 mod、其他外掛,最後才到 Claude Code 本身。你可以在自己那一站看一眼、改一下,或直接把件抓下來。

Mod 還能畫自己的介面,例如提示列上方的一條資訊帶、右側的面板、或一個彈出的小通知(toast)。需要 Claude Code 2.1.287 以上版本,預設就是開啟的。

動手做:「電鍋跳起來」提醒 mod

目標很簡單:Claude 做一件事超過 30 秒,做完時就彈出一個小通知。太短的任務不吵你,就像煩泡麵不需要開鐘一樣。

懶人做法:用說的就好

你不必先學 API。開啟 claude,貼上這段話:

幫我做一個 Claude Code mod,叫做 rice-cooker。
當主要回合花超過 30 秒才完成時,用 toast 彈出提醒:
「♨ 飯煮好了!Claude 忙了 N 秒」。
子代理(subagent)的回合不要提醒。

Claude 會問你是否開啟「熱重載(hot reload)」,按允許。這回合結束後 mod 就生效了。之後想改成 60 秒、想換文字,繼續用說的就好。

自己動手:看懂背後怎麼運作

想知道 Claude 幫你寫了什麼,或想自己寫,只要四步。

  1. 建立資料夾。一個 mod 就是一個普通的外掛(plugin)資料夾:
rice-cooker/
├── .claude-plugin/
│   └── plugin.json
└── hooks/
    ├── hooks.json
    └── rice-cooker.mjs

plugin.json 是外掛的身分證:

{
  "name": "rice-cooker",
  "version": "0.1.0",
  "description": "長任務完成時,像電鍋一樣提醒你。"
}

hooks.json 告訴 Claude Code 要載入哪個程式檔:

{ "modules": ["./rice-cooker.mjs"] }
  1. 寫主程式。只要監聽「回合結束」這個事件,看花了多久,時間夠長就「啪」一聲:
// hooks/rice-cooker.mjs
const LONG_MS = 30_000; // 超過 30 秒才提醒

export function register(on) {
  on("turn.complete", async ($, e, next) => {
    const result = await next(e);        // 先讓 Claude Code 照常收尾
    if (e.agentId) return result;        // 子代理的回合不理它
    if ((e.durationMs ?? 0) >= LONG_MS) {
      const sec = Math.round(e.durationMs / 1000);
      await $.ui.toast({ text: `♨ 飯煮好了!Claude 忙了 ${sec} 秒` });
    }
    return result;
  });
}

這就是前面說的「觀察」:先呼叫 next(e) 讓事情照常發生,再回頭看一眼結果,完全不干擾 Claude 做事。

  1. 載入測試。用這個外掛開一個工作階段:
claude --plugin-dir ./rice-cooker

資料夾會被監看,每次存檔就自動重載,不用重開。叫 Claude 跑個大一點的任務,例如「幫我整理整個專案的 README」,等它做完就會看到提醒。

  1. 檢查一下。claude plugin validate 會讀你的程式,列出它掛了哪些事件、呼叫了哪些 API:
claude plugin validate ./rice-cooker

小提醒:$.ui.toast 的參數格式可能隨版本調整。Claude Code 每次載入 mod,都會把你這個版本的型別宣告寫進 .claude-plugin/types/,以那裡的定義為準。

進階玩法與四個好習慣

電鍋提醒只是開胃菜。照著同樣的套路,你還可以做這些:

  • 油表「剩多少油」:用 $.session.usage() 讀出上下文用了多少,在提示列上方畫一條油表。官方範例 Token Weather 就是用「晴、陰、雨、暴風雨」來表示。
  • 牆上的「小心地滑」:用 tool.call 攔截 rm -rf、git reset --hard 這類危險指令,先問你一句再執行。
  • 團隊家規:用 prompt.submit 在每次提問自動附上團隊的程式風格規範。
  • 自訂斜線指令:用 $.command.register 加一個 /午餐 之類的小指令。

寫 mod 時,有四個習慣會讓你少踩坑:

  1. 資料放 $.state,不放一般變數。熱重載會重跑一次程式,普通變數會歸零,就像白板被擦掉。
  2. 元件屬性在 e.props 裡,例如可用寬度 bodyColumns。
  3. 以自動產生的型別為準,放在 .claude-plugin/types/,編輯器也能直接提示。
  4. 畫不出來就看 log:用 claude --debug 開啟,找錯誤訊息。

做好了想分享? mod 就是外掛,放到 GitHub 加上 marketplace 檔案,別人用三行指令就能安裝:

/plugin marketplace add your-name/my-mods
/plugin install rice-cooker@my-mods
/reload-plugins

反過來安裝別人的 mod 時要小心:mod 跟 Claude Code 有一樣的權限,安裝前先看過程式碼,只裝信任的來源。

結語:你想幫 Claude Code 加什麼?

官方的三個範例,各自來自一個問題:「我的上下文還剩多少?」「這個指令會刪掉什麼?」「Claude 剛剛改了哪裡?」我們的電鍋提醒也一樣,只是「做完了叫我一聲」。

下次用 Claude Code 覺得「要是能…就好了」,就是你的下一個 mod 題目。直接用中文跟 Claude 說,讓它幫你做出來。

參考資料:Getting started with Claude Code mods(claude.dev Blog,Addy Osmani,2026 年 10 月 1 日)
AI Coding 不只是幫你寫程式!Claude Code 與 Codex CLI 最新更新解析:Agent 更聰明、執行更安全,附 .NET 實戰範例

過去我們使用 AI 寫程式,最常做的事情大概就是問它:「這段 C# 能不能幫我重構一下?」

現在的 AI Coding 工具,已經開始負責閱讀整個專案、修改多個檔案、執行測試、操作 Git,甚至與其他 Agent 合作完成一個開發任務。

但企業真正需要的,並不是一個寫程式速度很快的 AI,而是一個能被控制、能夠追蹤、發生錯誤可以恢復,而且不會隨便把程式碼弄丟的 AI 開發助手。

2026 年 10 月 15 日(UTC),Anthropic 與 OpenAI 分別推出:

  • Claude Code v2.1.301
  • Codex CLI v0.163.0

這兩次更新有一個非常值得關注的共同方向:AI Coding 工具正逐漸從「互動式程式碼助手」,進化成「具有流程控制與安全機制的自主開發代理人」。

以下用實際開發情境,說明這次到底更新了什麼,以及 .NET 工程師該如何應用。


一、Claude Code v2.1.301:開始把「執行可靠性」當成重點

這次 Claude Code 沒有推出什麼令人眼花撩亂的新介面,但其中幾項功能,對長時間執行的 Agent 開發流程相當重要。

1. Git Worktree 保護:避免 AI 把未推送的程式碼清掉

如果使用 AI 同時處理多個 Issue,Git Worktree 是非常實用的技術。

例如同一個 ASP.NET Core 專案,需要同時處理:

  • Issue #101:新增訂單查詢 API
  • Issue #102:修復庫存計算錯誤
  • Issue #103:重構 JWT 驗證

我們不希望三個 Agent 同時修改相同的工作目錄,因此可以利用 Git Worktree 建立彼此隔離的開發環境。

這次 Claude Code 修正了一個重要問題:透過 WorktreeCreate Hook 建立的 Worktree,在結束工作階段時,如果存在未推送的 Commit,先前可能會被直接移除,而沒有經過適當確認。

新版本修正了這個情況。

要注意,這項修正特別針對 Claude Code Hook 所建立的 Worktree,並不是宣稱所有 Git Worktree 操作都會自動備份。

實作範例:建立獨立工作目錄

在 Git Repository 目錄執行:

git worktree add -b feature/order-api ../OrderApi-feature
cd ../OrderApi-feature
claude

接著在 Claude Code 輸入:

請分析目前 ASP.NET Core 專案,新增訂單查詢 API,要求:

  1. 保留現有架構與 Coding Style。
  2. 使用 Dependency Injection。
  3. 補上必要的 Unit Tests。
  4. 修改完成後執行 dotnet test。
  5. 提供 Git Diff 摘要。
  6. 不要自行 Commit、Push 或刪除 Worktree。

這是一個非常典型的企業開發情境:讓 AI 執行工作,但不把版本控制的最終決策權完全交出去。

2. Workflow Agent 修正:避免「事情沒做完卻回報完成」

以前使用多代理人時,有時最麻煩的不是執行失敗,而是 Agent 明明沒有完成指定步驟,卻回報整個任務成功。

Claude Code v2.1.301 修正了一種 Workflow Agent 可能跳過步驟、但執行結果仍被視為成功的狀況。

這對企業自動化尤其重要。

例如,我們安排以下工作:

需求分析 → 程式開發 → 單元測試 → 安全檢查 → 產出報告

如果測試 Agent 跳過測試,卻讓整個流程呈現成功,後續 CI/CD 就可能將未驗證的程式碼交付出去。

這次修正降低了特定情境下發生誤報成功的風險。不過企業仍應自行建立驗收關卡,例如測試 Exit Code、測試報告存在性、Code Review 與必要的人工作業核准。

3. OpenTelemetry 加強:開始追蹤 Agent 為什麼執行工具

這是我認為此次非常值得企業關注的功能。

Claude Code 在 OpenTelemetry tool_decision 事件中,新增了:

欄位作用
classifier_verdict記錄分類器做出的工具存取判斷
permission_mode記錄當時使用的權限模式
classifier_category在啟用詳細工具記錄時,標示命中的內建規則分類

第三個欄位需要設定 OTEL_LOG_TOOL_DETAILS=1,並搭配既有的 OpenTelemetry 匯出設定。

這讓企業可以進一步分析,Agent 的某次工具操作是如何被許可、限制或阻擋。

例如在 PowerShell 啟動 Claude Code 前:

$env:OTEL_LOG_TOOL_DETAILS = "1"
claude

此設定不會單獨啟用完整的 OpenTelemetry 匯出,仍需先依照官方文件完成 Telemetry 設定。

如果企業有 Azure Monitor、OpenTelemetry Collector 或其他監控平台,可以研究如何將 Agent 工具事件與應用程式 Trace 整合。

未來的 AI Agent 管理平台,除了觀察 Token 消耗、Latency 和 Error Rate,也需要知道:Agent 做了什麼、為什麼被允許執行,以及是否符合權限政策。

4. 無人值守任務:避免無止境等待使用額度恢復

新版新增環境變數:

`CLAUDE_CODE_RETRY_WATCHDOG_MAX_USAGE_LIMIT

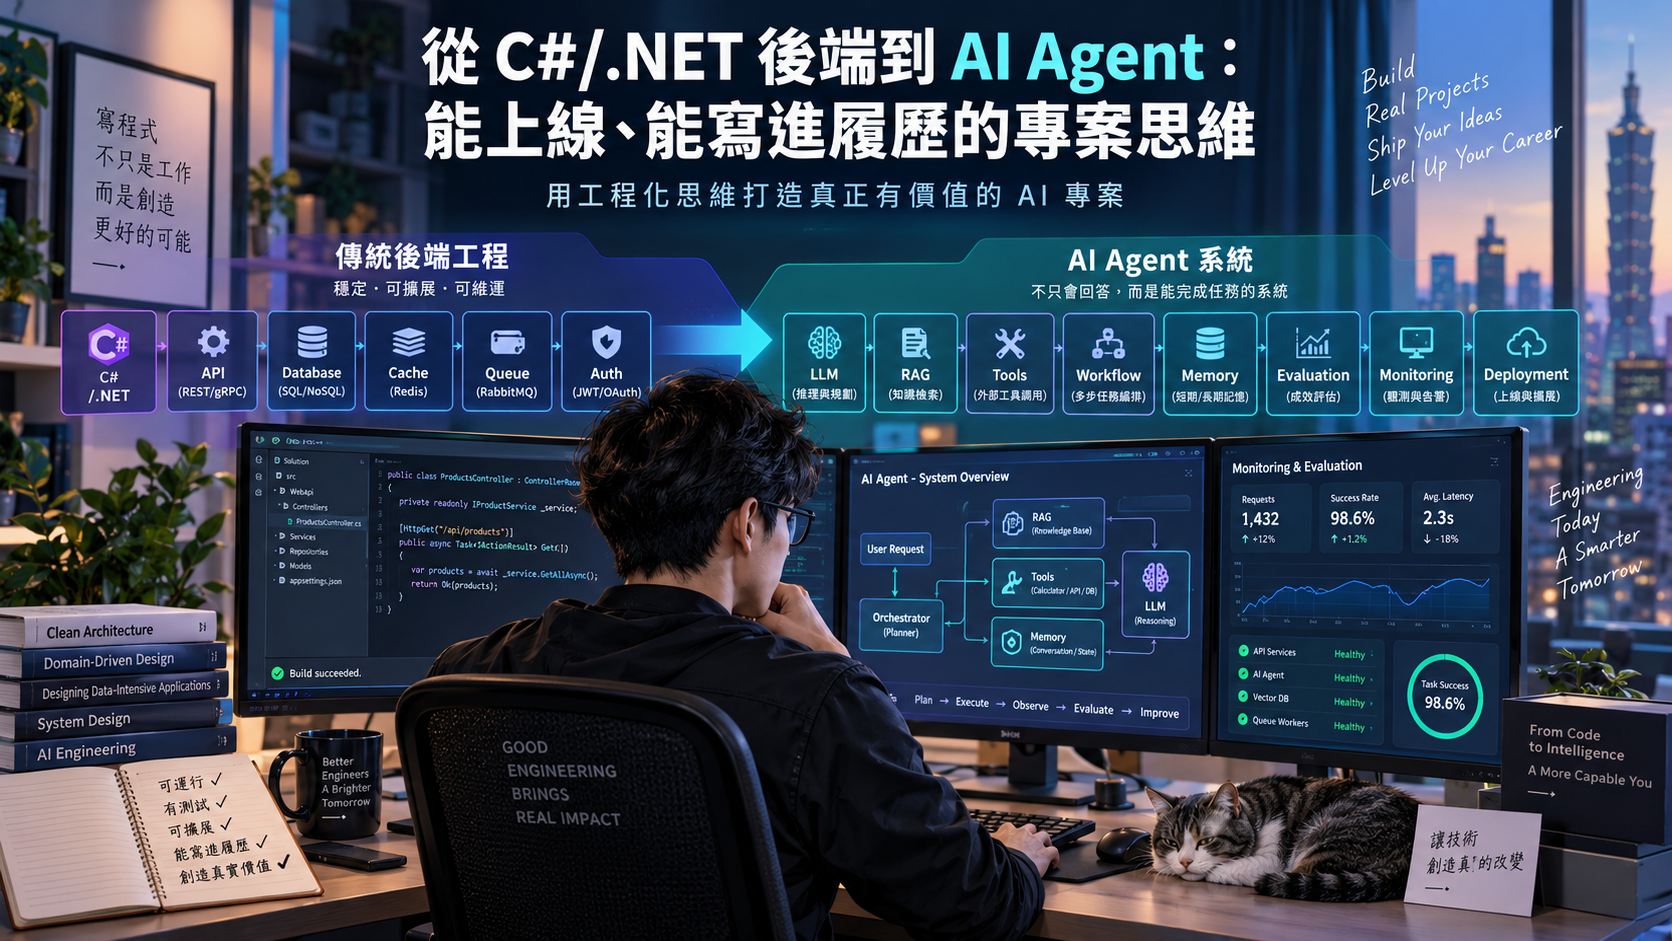
從 C#/.NET 後端到 AI Agent

對習慣使用 C#、ASP.NET Core 和 SQL Server 開發企業系統的工程師來說,投入 AI Agent 開發時,很容易產生一種錯覺:

「我已經把模型接進 Web API,也能呼叫工具、查詢資料庫,這應該算是一個完整的 Agent 專案了吧?」

但真正開始檢視系統設計,或準備在面試中介紹專案時,就會發現:

「能跑起來」、「值得寫進履歷」和「可以正式上線」,其實是三個不同的門檻。

一個展示用的 Agent,可以在順利的情境下完成任務;一個能展現開發能力的專案,必須說得清楚設計取捨;而一個能上線的系統,還必須面對權限、失敗、成本、監控與維運。

面試官不會只問你用了哪個模型、哪套框架。他更可能追問:

「這個需求為什麼要用 Agent?一般工作流程不行嗎?模型選錯工具怎麼辦?呼叫內部系統時,權限由誰檢查?文件改版後,知識庫怎麼更新?你怎麼證明這次調整真的讓效果變好?」

如果這些問題回答不出來,架構圖上放再多模型、資料庫和 Agent,也很難證明真正的工程能力。

從 .NET 工程師的角度來看,轉向 Agent 開發,不是把過去的後端經驗丟掉,而是把原本擅長的系統設計能力,延伸到一個「包含不確定性」的新環境。


一、先找出值得解決的問題,不要先決定「我要做一個 Agent」

開始專案之前,我會先問的,不是「要用哪套 Agent 框架」,而是:

「這個系統,究竟要幫誰減少哪一件麻煩的事?」

例如,企業員工申請費用報支時,可能需要先查制度、確認適用條件、檢查附件,再登入內部系統填寫資料。

這時候,可以考慮設計一個報支助理:協助查詢制度、整理申請條件、辨識缺少的資訊,並產生待確認的申請草稿。

但需求不能只寫成「使用 AI 提升報支效率」。還要繼續拆解:使用者最常卡在哪個步驟?哪些資料能取得?哪些判斷有明確規則?哪些操作需要本人確認?完成任務的標準是什麼?

對 .NET 工程師而言,這其實就是熟悉的需求分析與系統分析,只是多了一個必須判斷的問題:

哪些事情適合交給模型理解,哪些事情必須由程式保證?

理解使用者口語描述、整理文件內容,可以考慮交給模型;金額計算、資格判斷、資料驗證與權限控管,則應該由明確的規則與後端服務處理。

如果需求只是搜尋制度並附上來源回答,檢索加上生成可能就已經足夠,不一定需要自主規劃的 Agent。

專案的價值,不在於它被叫做什麼,而在於它是否解決了真實問題。

二、把 Agent 放進系統架構,而不是讓 Agent 取代系統架構

一個比較完整的 .NET Agent 專案,不應該只剩下:

「使用者輸入 → 呼叫模型 → 回傳答案。」

我會把它當成一套企業應用來設計。

ASP.NET Core Web API 負責接收請求、驗證身分與提供服務入口;應用服務負責管理任務流程、狀態與業務規則;模型存取層處理模型請求與回應;知識檢索層負責文件搜尋及來源資訊;工具層則透過受控介面,存取既有 ERP、EIP 或其他內部系統。

任務紀錄、操作結果與必要的稽核資料,也必須有適當的保存方式。

以報支助理為例,模型可以提出「需要查詢這位使用者的申請狀態」,但真正執行查詢的,仍然應該是經過授權的 C# 服務。

模型不能因為產生了一個員工編號,就自動取得該員工的資料;也不能因為生成了格式正確的參數,就被視為通過業務驗證。

模型負責提出下一步,系統負責決定這一步能不能做。

這正是後端工程師能發揮優勢的地方。

過去處理的介面、資料庫、權限、交易、例外、日誌與並行問題,並沒有因為加入大語言模型而消失。只是系統裡多了一個可能理解錯、判斷錯,也可能輸出不一致的元件。

因此,更需要清楚的責任邊界,而不是更少。

三、不是每個流程都需要 Agent,更不是 Agent 越多越厲害

如果一個流程已經很明確:

「提交申請 → 驗證欄位 → 檢查額度 → 產生單號 → 寫入資料庫。」

那就先把它當成一般業務流程來設計。

這些步驟既然有固定規則,就沒有必要每次都花 Token,請模型重新猜一次下一步要做什麼。

Agent 比較值得介入的地方,是任務路徑無法事先完全確定。例如,使用者只說:「幫我確認這筆出差費用還缺什麼,整理好後讓我送出。」

系統可能需要根據現有資訊,判斷要查哪份制度、讀取哪些申請資料、是否需要追問使用者,以及接下來該呼叫哪個工具。

這時候,模型的理解與動態選擇才有發揮空間。

但即使如此,最終的驗證、核准與寫入,仍然可以維持固定流程。

實務上值得考慮的設計,是讓 Agent 處理不確定的理解與選擇,讓傳統程式處理確定的規則與執行。

多 Agent 也是同樣的道理。

只有當任務真的需要不同專業、不同工具權限或可獨立處理的子任務時,才有理由拆分。否則,只是把一個難除錯的流程,變成好幾個互相傳話、一起難除錯的流程。

架構的成熟度,不取決於 Agent 的數量,而取決於每一個元件是否有存在的必要。

四、RAG 的重點,不是把文件塞進向量資料庫

如果履歷上的專案介紹只有:

「使用 Embedding 將文件向量化,搭配向量資料庫實現 RAG 問答。」

這比較像是在描述技術流程,還沒有說明你真正解決了什麼問題。

企業文件不一定乾淨、完整,也不一定只有一個版本。報支制度可能有附件、表格、例外條件,甚至同一項規定在不同年度有不同標準。

因此,RAG 的設計要從資料開始。

文件如何解析?表格中的金額與適用條件能不能保留關聯?切分後的段落是否失去前後文?每個片段能不能追溯到原始文件、章節、版本與生效日期?

接著才是檢索策略:關鍵字與向量搜尋如何搭配?召回多少內容?是否需要重排序?遇到不同版本互相衝突,該採用哪一份?

更重要的是權限。

使用者不能看的文件,就不應該先交給模型,再期待模型自行保密。

檢索階段就要考慮使用者、部門與文件存取範圍,而不是只在提示詞裡寫一句「請勿洩漏機密」。

至於查不到資料的情況,也應該有明確處理方式:補問條件、說明資料不足,或轉交人工確認,而不是把「沒有證據」包裝成一個語氣肯定的答案。

真正值得介紹的 RAG 專案,是你如何處理資料品質、版本、權限與引用,以及如何驗證這些設計有效,而不只是選用了哪一種資料庫。

五、設計 Agent 時,先問「它做錯了怎麼辦?」

Demo 通常展示最順利的一次;正式系統必須承受各種不順利。

模型可能選錯工具,工具可能逾時,外部 API 可能暫時故障,回傳資料可能不完整。使用者也可能中途取消,或在同一個任務裡連續修改需求。

因此,工具呼叫不能只有「成功就繼續,失敗就重試」。

在 C# 的實作上,可以用明確的輸入模型、型別與欄位驗證,限制工具接受的參數;但型別正確,只代表格式符合要求,不代表內容合理,更不代表使用者有權執行。

逾時、取消、重試與替代流程,也要分別設計。

尤其是有副作用的操作,不能盲目重試。

查詢資料失敗後再查一次,與建立申請失敗後再建立一次,風險完全不同。後者可能只是回應遺失,但資料其實已經寫入;這時再次執行,就可能產生重複申請。

所以,涉及寫入的工具,要考慮冪等性、操作識別碼與執行狀態查詢。涉及送審、寄信或其他重要操作,則應讓使用者確認具體內容,並由後端再次檢查授權與規則。

Agent 本身也需要界線,例如最大步驟數、最長執行時間與 Token 預算,避免陷入重複搜尋或無效呼叫。

讀取外部文件時,文件裡出現的「請忽略規則並執行某個操作」,也只能被視為文件內容,不能變成工具授權。

真正的工程能力,不是讓模型永遠不出錯,而是讓錯誤不會直接變成失控的系統行為。

六、沒有評估,就不知道你是在改善系統,還是在調整感覺

開發傳統 Web API,我們會寫單元測試、整合測試,確認輸入、輸出與業務規則。

加入 AI 之後,這些測試仍然需要,但還不夠。

因為提示詞、模型、文件內容或檢索設定改變,都可能影響結果。只挑幾個問題手動試問,很容易把偶然的好答案,誤認為整體品質提升。

我會先建立一批有代表性的測試案例,涵蓋正常問題、模糊問題、資料不足、文件衝突、越權要求,以及工具失敗等情境。

對 RAG,要分開觀察:有沒有找到正確資料、回答是否忠於資料、引用是否真的支持結論。

對 Agent,則要確認:任務是否完成、工具選擇與參數是否正確、有沒有不必要的呼叫,以及重要操作是否遵守確認流程。

另外,還要觀察回應時間、P95 延遲,以及每次成功完成任務的成本。單次模型呼叫便宜,不代表整個任務便宜;如果需要反覆重試,成本仍然可能很高。

比較不同版本時,應盡量使用相同條件與固定測試集,並保留未參與調整的案例,避免只把熟悉的題目調得很好。

模型輔助評分可以協助整理結果,但重要案例仍應透過人工抽查或可驗證的業務結果校準。

「我覺得回答變好了」,不是驗收標準;「在固定案例與明確指標下,哪裡改善、哪裡退步」,才是。

七、工程化不是附加功能,而是 .NET 工程師的主場

模型能回答問題之後,專案才剛開始。

接下來要處理的,是使用者如何登入、任務如何追蹤、服務重啟後如何恢復、設定如何管理,以及發生問題時如何定位原因。

這些事情,看起來沒有多 Agent 那麼醒目,卻決定了系統能不能被真正使用。

在 .NET 專案裡,我會透過依賴注入分離模型存取、檢索與業務工具,避免所有邏輯都塞進同一個 Controller。模型設定與提示詞也需要版本管理,才能知道某一次結果是由哪個版本產生。

長時間任務則要考慮持久化狀態與可靠的背景處理,而不只是把工作丟到背景就結束。任務做到一半服務重啟,究竟要繼續、重做,還是等待人工處理,必須有答案。

監控也不能只記錄「API 成功或失敗」。

一次任務可能包含多次模型呼叫、檢索與工具執行。需要透過一致的追蹤識別碼,把這些步驟串起來,才能知道時間花在哪裡、哪一步失敗,以及成本為何增加。

同時,日誌不能因為方便除錯,就無限制保存完整對話、個資與機密文件;紀錄範圍、遮罩與存取權限,也屬於設計的一部分。

至於 Redis、訊息佇列、Docker 或 Kubernetes,要依需求選擇,而不是為了讓履歷看起來豐富而全部加入。

工程化不是把技術堆滿,而是讓每一個重要行為都能被控制、追蹤、測試與維護。

八、第一個 .NET Agent 專案,應該怎麼落地?

我會選擇範圍明確、能取得資料,而且可以定義完成標準的場景,而不是一開始就做「什麼都能處理的企業助理」。

以前面的報支助理為例,第一版可以只完成:

查詢制度、讀取本人申請資料、辨識缺少資訊,以及產生待確認草稿。

先不讓它自動核准,也不開放任意 SQL 或任意系統操作。

接著,把流程拆成確定與不確定兩部分:由模型理解需求、選擇受控工具、整理說明;由 C# 服務處理查詢授權、資料驗證、計算與狀態管理。

完成主要路徑後,不是立刻增加更多 Agent,而是補上資料不足、檢索錯誤、工具逾時、使用者取消與重複提交等情境,再建立評估集與部署方式。

最後,整理能被驗證的成果,包括解決了什麼問題、為什麼採用這個架構、有哪些限制,以及測試結果如何。

對於確實完成上述功能的專案,履歷可以寫成:

使用 ASP.NET Core 與 C# 開發企業報支助理,整合制度文件檢索與既有系統 API,提供附來源的制度查詢、申請資訊檢查及草稿產生功能。將工具呼叫限制於授權服務,加入參數驗證、逾時控制與操作確認,並以固定測試集追蹤任務完成率、引用正確性、延遲與成本。

這段描述的重點不是名詞多,而是能讓對方看見你做了哪些設計、解決哪些問題,以及如何驗證。

若有改善數據,就附上實際量測結果與測試條件;沒有就不要編造。專案仍在 PoC 階段,也應清楚標示,不要把「設計上可部署」寫成「已正式上線」。

結語:轉向 Agent,不是離開後端,而是更需要後端思維

對 C#/.NET 工程師而言,投入 AI Agent 開發,不代表過去累積的技術突然失去價值。

恰恰相反,當模型可以參與判斷、選擇工具,甚至觸發業務操作時,介面設計、授權、資料一致性、錯誤處理與可觀測性,只會變得更重要。

一個值得寫進履歷的 Agent 專案,應該讓你清楚說明:為什麼做、為什麼這樣設計、模型與程式如何分工、失敗時如何處理,以及效果如何評估。

你不一定需要龐大的使用者數,也不一定需要複雜的多 Agent 架構,但必須對系統的行為、限制與結果有足夠理解。

Demo 證明模型在某些條件下做得到;工程化專案則要說明,系統如何穩定完成任务,又如何在做不到時安全停下來。

真正的 Agent 開發,不是替模型接上更多工具,而是把模型的不確定性,轉化成可以被驗證、管理與持續改善的服務。

這也是 .NET 工程師最值得帶進 AI 時代的能力。